ポイ活メディア自動運用システム(ポイ活エージェント)
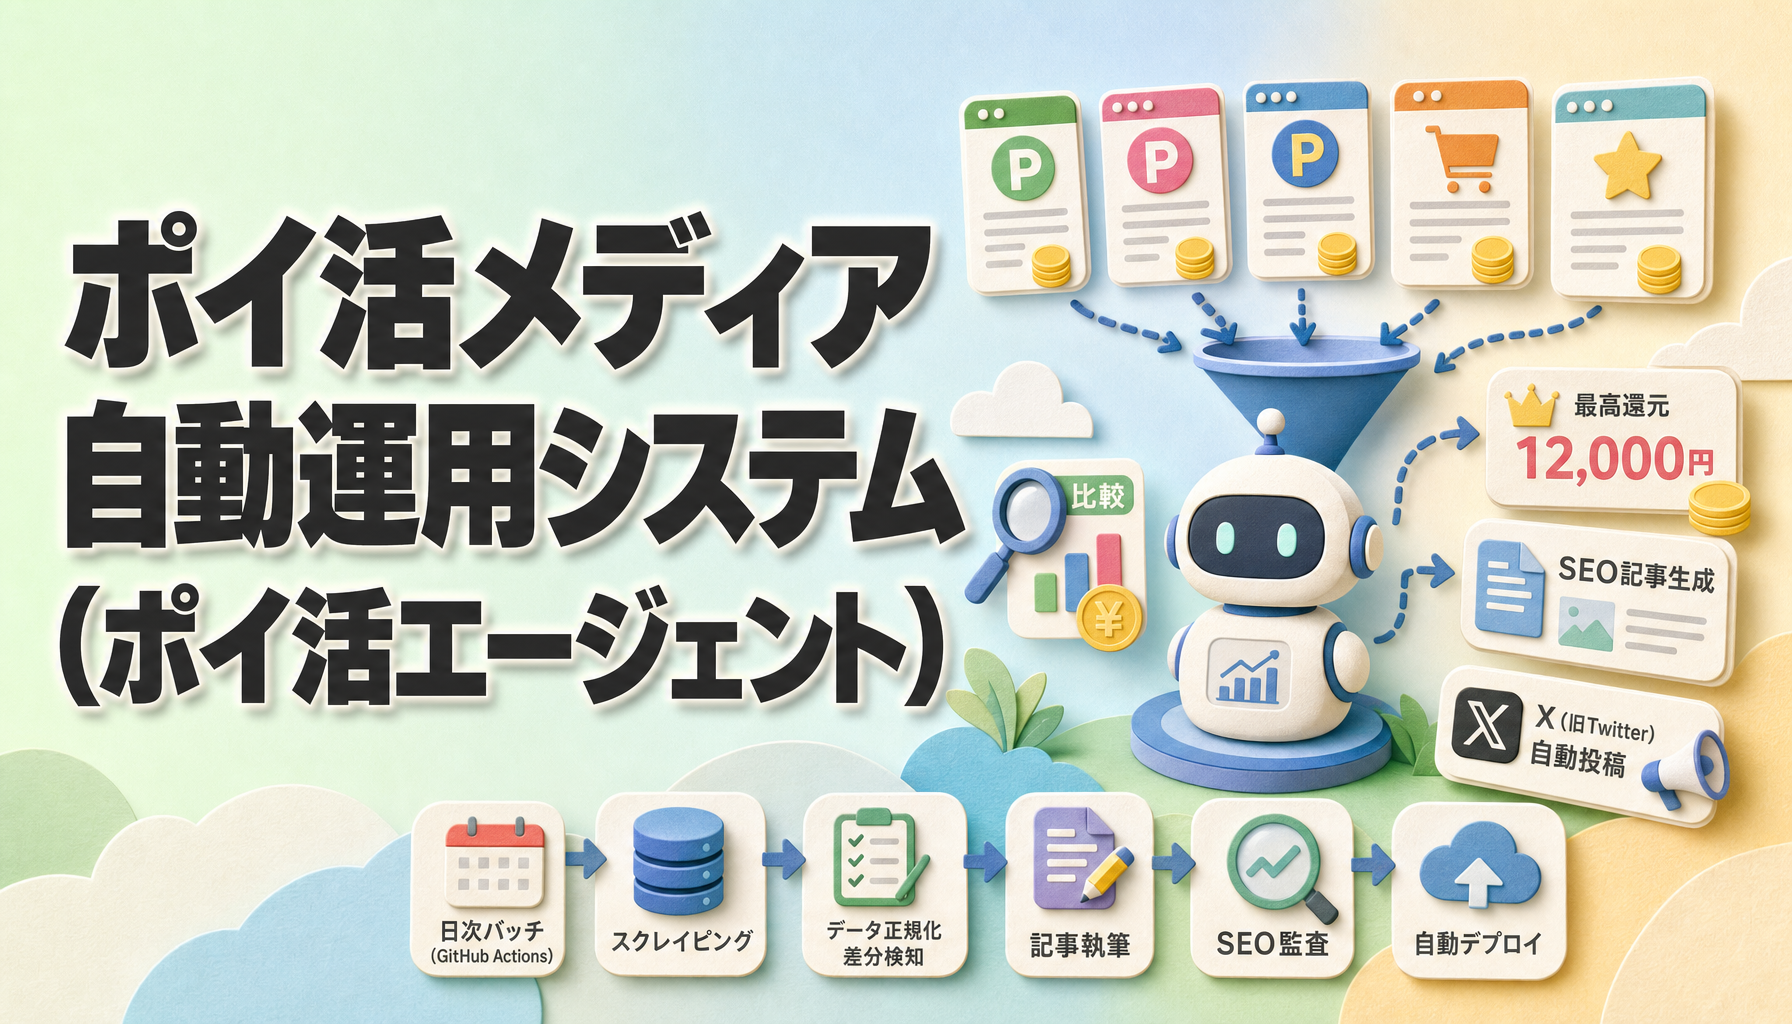
複数のポイントサイトから案件情報を自動収集し、最高還元額の比較やSEO記事の生成、SNS通知までを完結させるポイ活メディア運用エージェントです。
Next.jsとSupabaseを基盤に、スクレイピングからデータ正規化、差分検知、記事執筆、SEO監査までの各工程を専門のサブエージェントが自律的に実行します。
日々の運用では、GitHub Actionsと連携して日次バッチで案件を更新し、最高還元を更新した案件のX(旧Twitter)自動投稿や、最新トレンドに基づいたSEO記事の週次生成を自動化します。
エンジニアはClaude Codeを通じて「記事を書いて」「デプロイ前チェックをして」といった自然言語の指示を出すだけで、メディア運営の大部分を自動運転させることが可能です。
zip未取得
ポイ活エージェント — Claude Code プロジェクト
Claude Code の サブエージェント と skill で構成された、ポイ活案件の収集・正規化・告知・記事生成パイプライン。
---
アーキテクチャ
依頼 (Claude Code)
   │
   ▼
サブエージェント (.claude/agents/*.md)  ← 薄いオーケストレーター
   │  (skill を順番に呼ぶだけ)
   ▼
skill (.claude/skills/<name>/SKILL.md)  ← 実処理 (TypeScript コード骨格を内包)
   │
   ▼
プロジェクトの実コード (skills/ / lib/ / app/)設計の核: サブエージェントには判断だけを書き、処理は全部 skill に寄せる。新サイト追加・新ページ追加・新検査追加は、skill 1個の編集 (または1個追加) で完結する。
---
サブエージェント (8個)
| エージェント | 役割 | 起動タイミング | |
|---|---|---|---|
scraper | ポイントサイトから案件を取得 (`--mode=full\ | delta`) | GitHub Actions 日次バッチ |
normalizer | 取得データを正規化(DB 保存はしない) | scraper の後 | |
change-tracker | 差分検知・終了判定 (7日ルール)・日報生成 | normalizer の後 | |
notifier | 過去最高還元の案件を X に投稿 | change-tracker の後 | |
article-writer | 週1で SEO 記事を生成 | GitHub Actions 週次 / 手動 | |
page-builder | 新規ページの雛形生成 | 開発者の依頼 | |
seo-auditor | デプロイ前の SEO/型/Lighthouse 一括検査 | PR 時 / デプロイ前 | |
db-admin | Supabase スキーマ管理 | 開発者の依頼 |
詳細は agents-and-skills-design.md を参照。
---
skill (36個)
.claude/skills/
├── 設定基盤
│   └── config-loader               ← env を一元管理 (process.env を読むのはここだけ)
│
├── データ取得
│   ├── jina-reader                 ← r.jina.ai のラッパ
│   ├── point-site-extractor        ← サイト別パーサ (ディスパッチ)
│   └── rate-limiter                ← 連続リクエストのスロットル
│
├── 正規化
│   ├── deal-name-canonicalizer
│   ├── reward-parser               ← 「1,000円 → 1000円」
│   ├── slug-generator              ← URL 用 slug
│   └── category-classifier         ← LLM フォールバック
│
├── 永続化 (Supabase)
│   ├── supabase-sites-repo       ← color / initial / pros / cons / signup_bonus 等 UI 用フィールド込み
│   ├── supabase-deals-repo       ← sub_title / requirements / tags / is_active / last_seen_at
│   ├── supabase-history-repo
│   ├── supabase-articles-repo    ← article_category / read_time / view_count / tags / is_featured
│   └── supabase-codes-repo       ★ v1.2: 紹介コード(招待コード)
│
├── 差分管理 ★ (運用フェーズの主役)
│   ├── deal-diff-detector        ← {added, updated, unchanged, missing} を出す純粋関数
│   ├── deal-deactivator          ← 7日経過した active 案件を inactive 化
│   └── change-summary-formatter  ← 運営者向け日報 (Markdown)
│
├── 集計 ★ v1.2 追加
│   └── deal-history-aggregator   ← 30日推移 / 前日比 / min/max/avg / サイト別比較
│
├── SNS 通知
│   ├── x-poster                    ← Twitter API v2
│   ├── tweet-formatter             ← 280字保護
│   └── post-dedup                  ← tweet_log で重複検査
│
├── コンテンツ生成
│   ├── claude-prompt-runner        ← Anthropic SDK
│   ├── seo-article-template        ← 記事プロンプト
│   └── markdown-quality-check      ← 文字数/H2 数/meta 検査
│
├── SEO・メタ
│   ├── metadata-builder            ← Next.js Metadata
│   ├── jsonld-builder              ← WebSite/Breadcrumb/Product/Article
│   ├── sitemap-generator           ← app/sitemap.ts
│   ├── robots-generator            ← app/robots.ts
│   ├── ogp-image-generator         ← @vercel/og
│   └── breadcrumb-builder
│
├── UI
│   ├── tailwind-token-guard        ← 「白ベース・グリーンアクセント」検査
│   ├── component-scaffold
│   └── nextjs-page-scaffold        ← App Router 雛形
│
└── 検証
    ├── seo-checklist               ← title/description/canonical/JSON-LD
    ├── lighthouse-runner           ← LCP/CLS/INP
    ├── link-checker                ← 404・アフィ URL
    └── ts-strict-validator         ← any/@ts-ignore/process.env
---
セットアップ
1. プロジェクトに配置
このディレクトリ構造を、Claude Code を動かしたい Next.js プロジェクトのルートに配置:
your-nextjs-project/
├── .claude/
│   ├── agents/      ← サブエージェント定義
│   └── skills/      ← skill 定義
├── .env.example
├── .gitignore
├── CLAUDE.md        ← プロジェクト全体規約
└── (Next.js のファイル)
2. 環境変数
cp .env.example .env.local
# 各キーに実値を埋める
3. 依存パッケージ (各 skill が要求)
# Supabase 系
npm i @supabase/supabase-js

# 取得系
npm i undici  # または fetch ポリフィル
npm i p-limit

# AI
npm i @anthropic-ai/sdk

# X
npm i twitter-api-v2

# 検証
npm i -D jsdom @types/jsdom lighthouse chrome-launcher

# UI
npm i @vercel/og
npm i zod  # config-loader 用
4. Claude Code で起動
このディレクトリで claude コマンドを実行。サブエージェントは自動で発見されます。
# 例
> scraper エージェントで全サイトを巡回して
> page-builder で /category/[category] のページを作って
> seo-auditor でデプロイ前チェックを走らせて
---
設計上の固い約束
process.envの直接参照はconfig-loaderskill 内のみ
- 他で書いたら
ts-strict-validatorが CI で落とす - 環境変数の追加・改名は
config-loader/schema.tsの編集だけで済む
- サブエージェントに処理ロジックを書かない
- サブエージェントは skill を順番に呼ぶ司令塔
- 「Jina で取得 → パース → DB 保存」は 3 個の skill (
jina-reader/point-site-extractor/supabase-deals-repo) を順番に呼ぶだけ
- skill の責務は単一
tweet-formatterは文字列を作るだけ (X API は触らない)x-posterは投稿するだけ (フォーマットも重複検査もしない)- 組み合わせは呼び出し側 (サブエージェント) の仕事
- 白ベース・グリーンアクセントを守る
tailwind-token-guardがページ内のクラス名を検査bg-purple-*bg-pink-*等は禁止- グリーンの広面積背景 (
min-h-screen bg-green-600等) も禁止
- CLAUDE.md がプロジェクト全体規約の唯一のソース
- 各 skill / エージェントは CLAUDE.md を参照する形で書く
- CLAUDE.md と矛盾する記述は skill 側を直す
---
デプロイ前チェックリスト
# 型違反検査
npm run lint:ts-strict

# Tailwind 色規約検査
npm run lint:tailwind

# SEO/Lighthouse/リンク 一括検査 (Claude Code で seo-auditor を起動)
> seo-auditor でデプロイ前チェックを走らせて
すべて緑になってからデプロイ。